Come funziona
Una pagina passa per cinque fasi. Quattro le fa il software. La quinta è una persona che dice sì, e senza quel sì non si pubblica niente.
1 · Acquisizione
Ogni file ha la sua impronta, ogni documento i suoi diritti
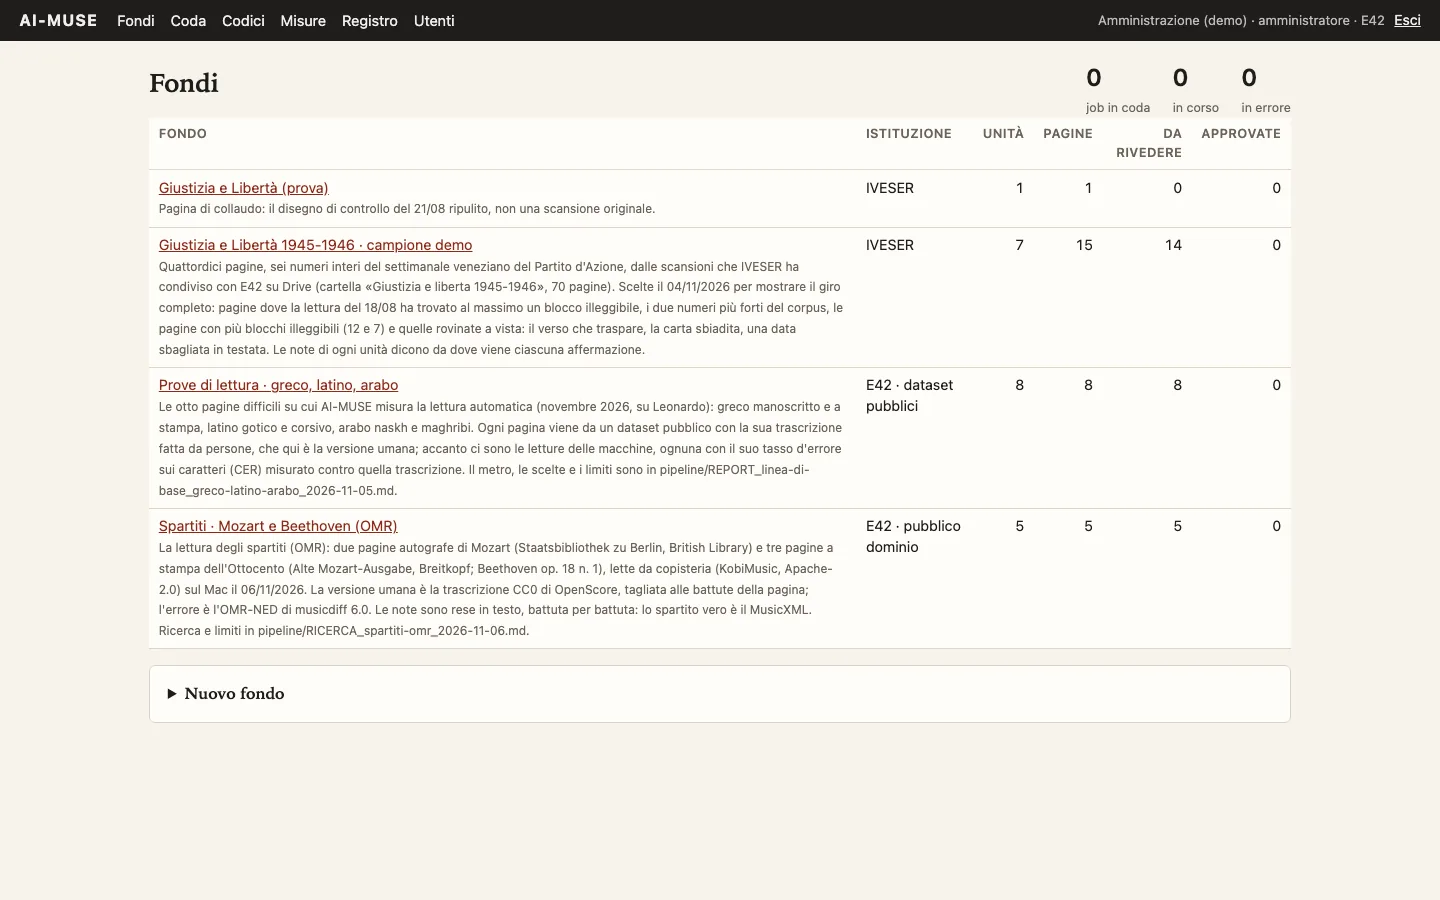
Ogni scansione riceve un'impronta SHA-256, se ne controllano dimensione e risoluzione, e una scansione sotto le specifiche viene segnalata invece di essere accettata in silenzio. I diritti si registrano documento per documento, a cura dell'istituzione. Il materiale con diritti poco chiari viene conservato e si può consultare, ma la coda di lettura lo rifiuta.
2 · Taglio
Un clic, e la pagina è divisa in blocchi
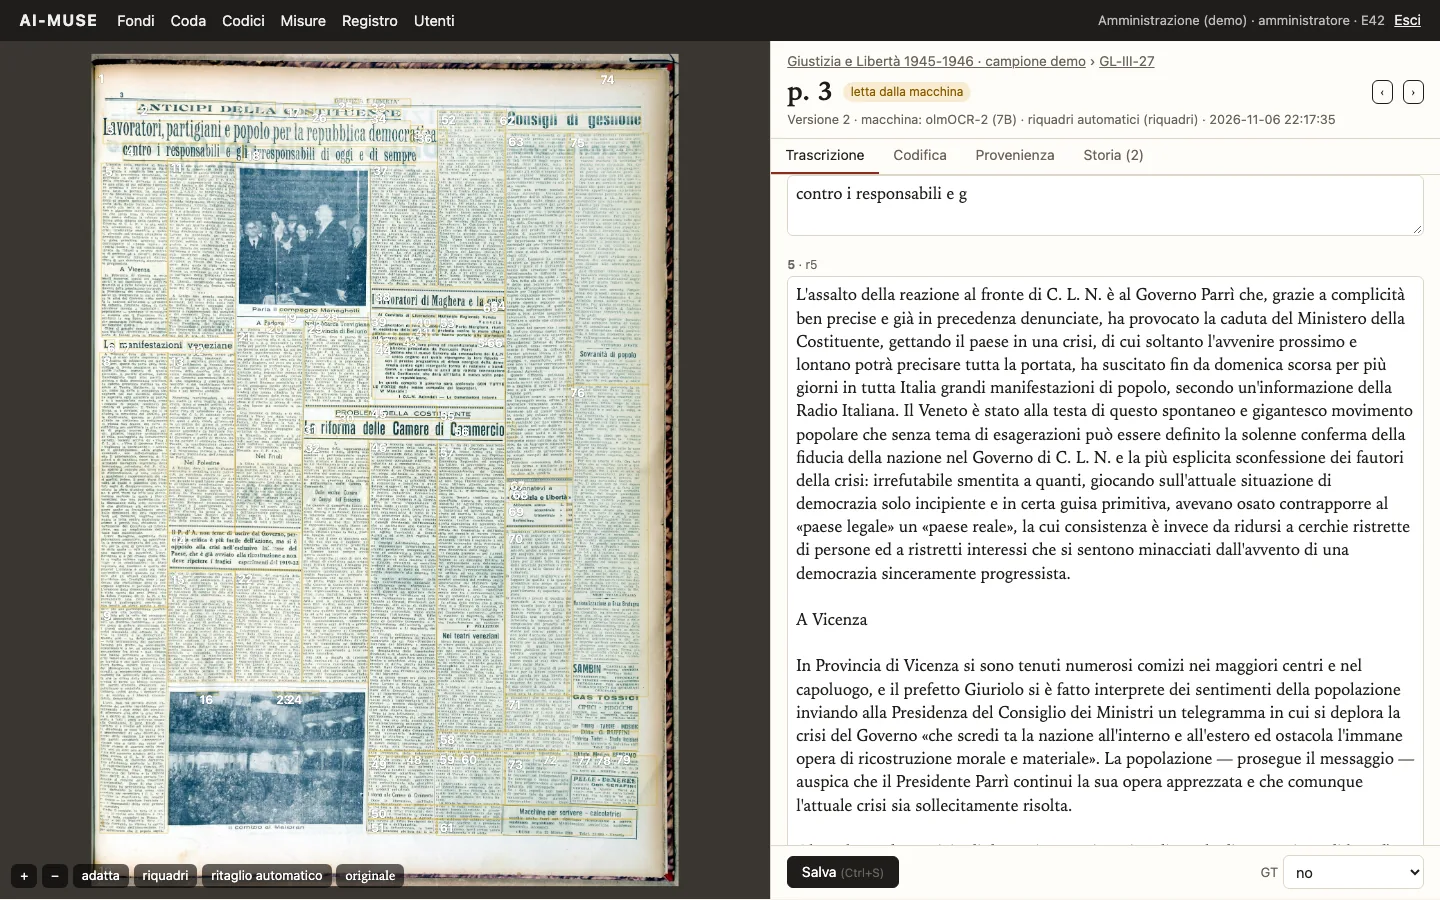
Una pagina di giornale è fatta di sei colonne, titoli che le attraversano, fotografie e pubblicità. Se la leggono tutta insieme, i modelli perdono il segno e cominciano a ripetersi. Così la pagina viene prima tagliata in blocchi, seguendo l'inchiostro, e ogni blocco viene letto da solo: su questa prima pagina, 79 blocchi di testo in meno di un secondo, senza GPU.
3 · Lettura
Ogni blocco va al modello che legge meglio quella scrittura
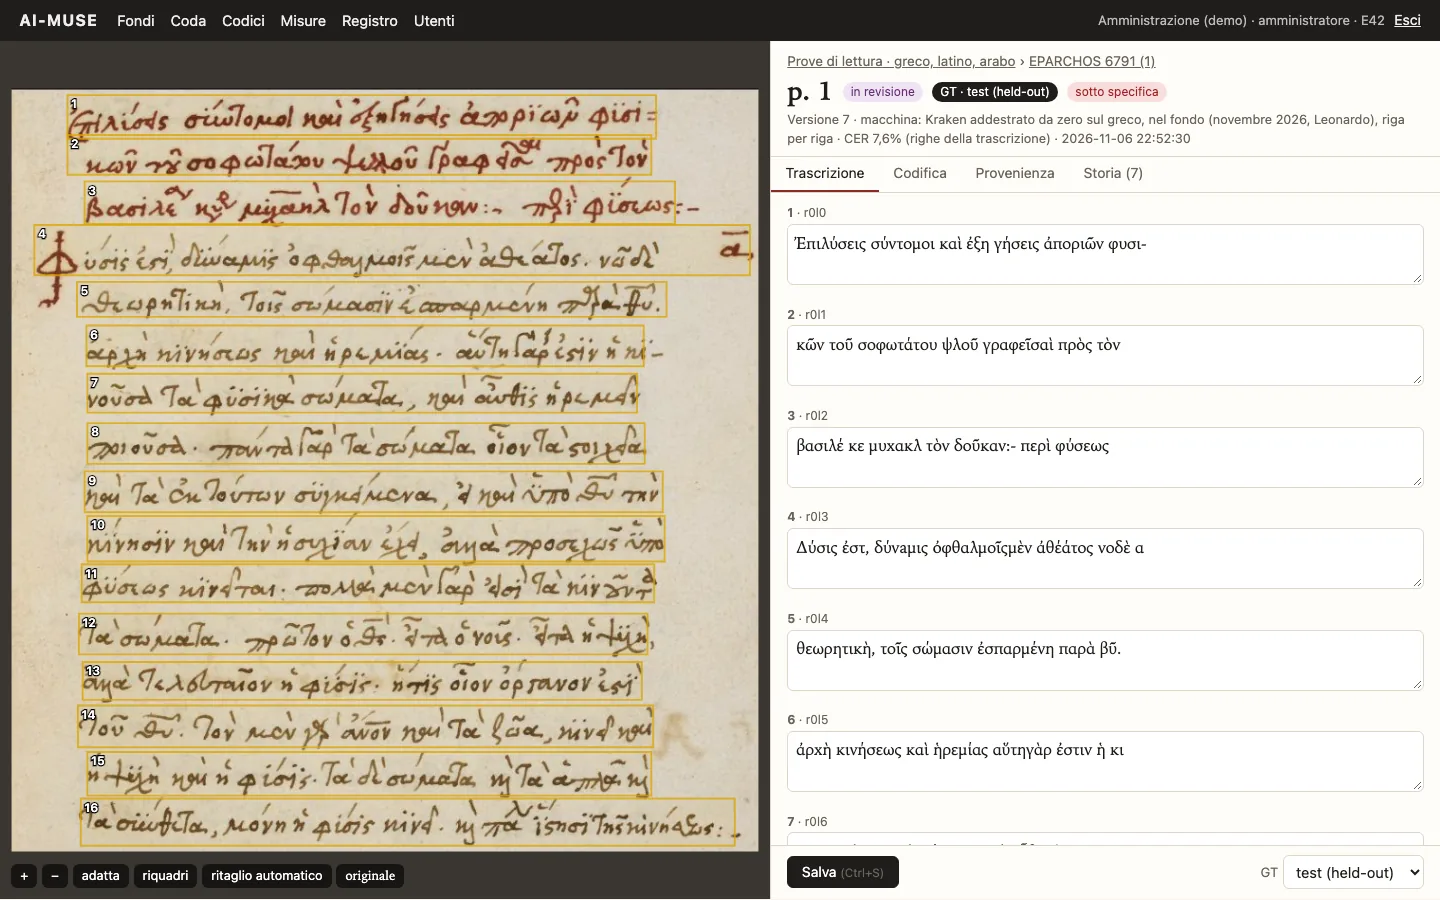
Per la stampa, modelli generalisti di visione e linguaggio come olmOCR-2 e LightOnOCR. Per la scrittura a mano, riconoscitori di righe costruiti con Kraken, che addestriamo sulla collezione stessa. Per la musica, copisteria, che scrive MusicXML. Quale modello legge quale materiale lo decide la misura, non l'abitudine: si vedano i Risultati.
AI-MUSE ha ottenuto risorse di calcolo attraverso IT4LIA AI Factory (EuroHPC), progetto EHPC-AIF-2026PG01-1068. L'elaborazione gira su Leonardo Booster, CINECA Bologna.
4 · Revisione
Una persona lo legge, lo corregge e lo approva
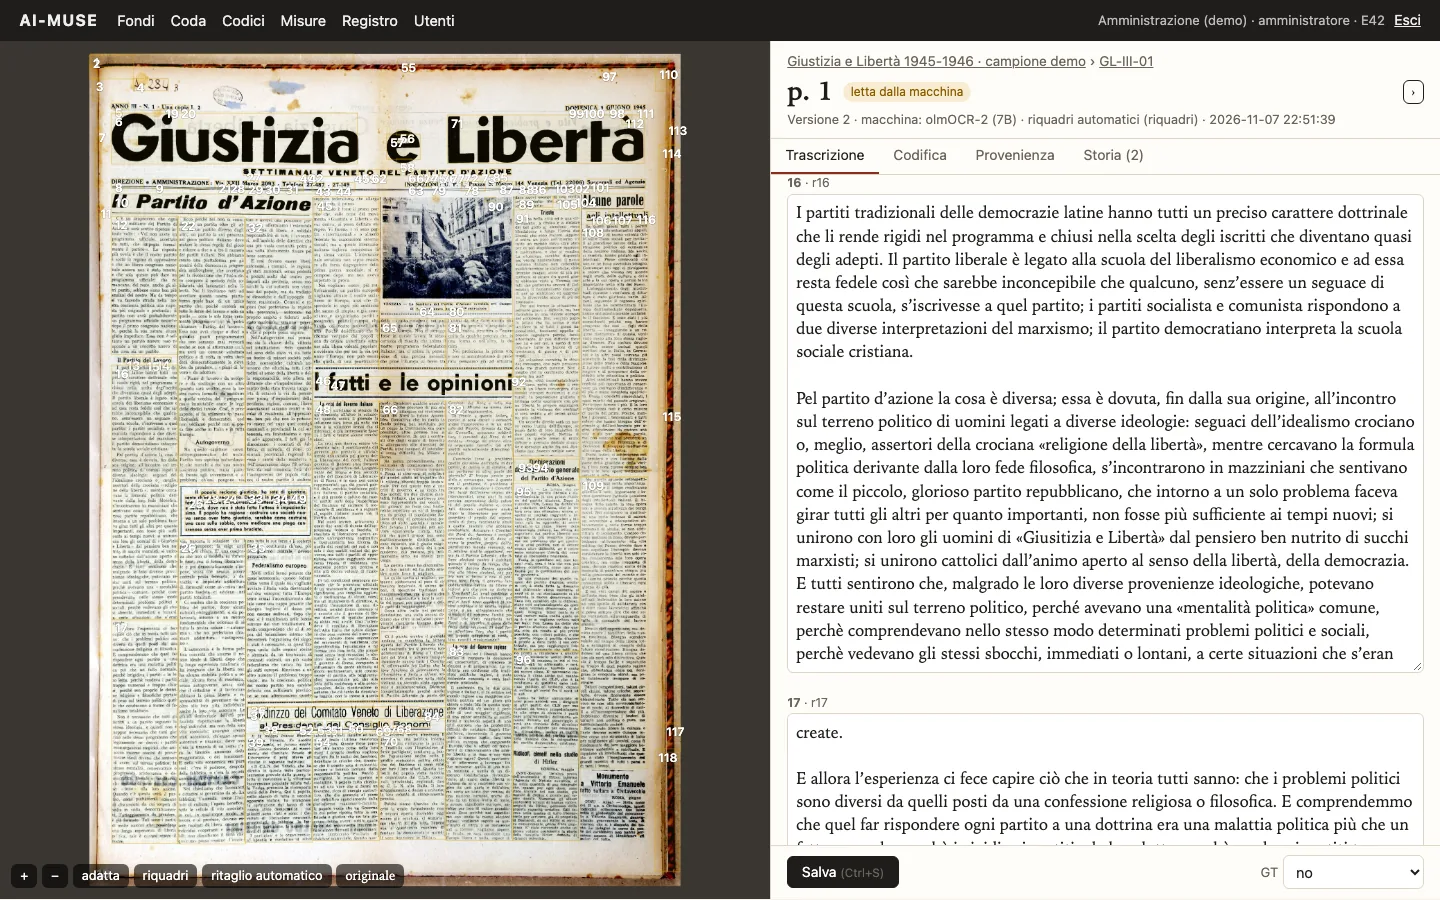
La persona nel ciclo (human-in-the-loop) è il cuore della nostra architettura. Non sostituiamo lo studioso: gli togliamo la fatica estenuante di battere le lettere a mano e diamo ai ricercatori la velocità del supercalcolo, perché possano concentrarsi sul giudizio storico, sul contesto e sulla critica, dove il loro lavoro vale di più. Quello che prima richiedeva mesi di trascrizione meccanica è pronto in poche ore per la revisione degli esperti.
Il curatore lavora in un editor che somiglia alla pagina: la scansione da una parte, il testo dall'altra, il blocco sotto il cursore illuminato su tutte e due. Ogni lettura viene conservata con il suo modello, il metodo, la data e il job di calcolo, così una correzione non cancella mai da dove viene il testo.
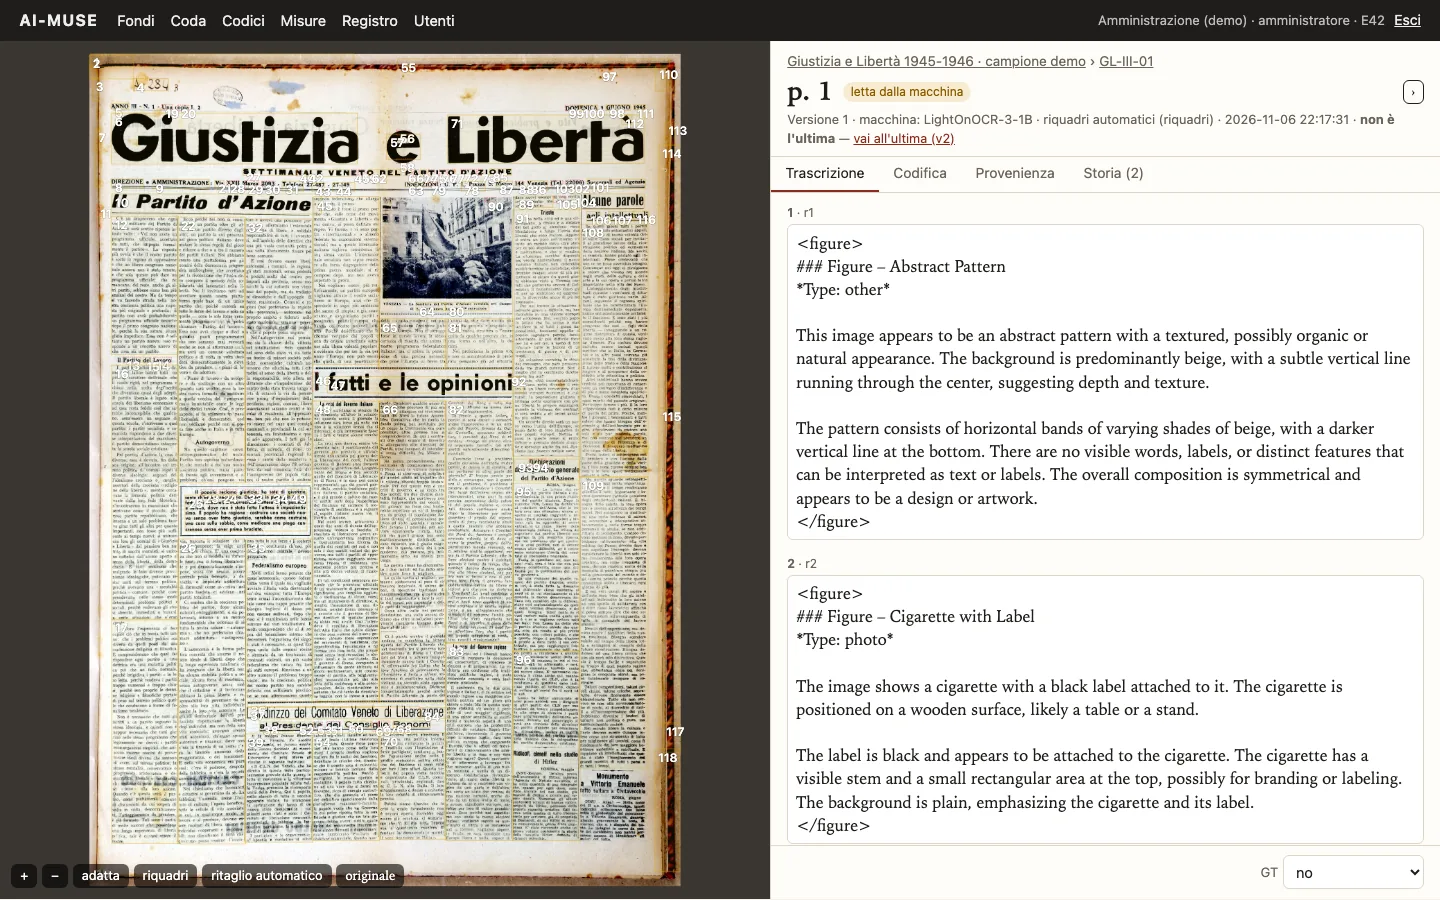
Alcuni errori l'editor li vede: un modello che si ripete senza fine, o si ferma a metà, riceve un avviso e un riquadro rosso. Altri non li può vedere. In questa schermata un modello generalista, davanti a un blocco di giornale, descrive «un motivo astratto» e «una sigaretta con un'etichetta nera». In inglese suona plausibile, e solo chi legge si accorge che sulla pagina non c'è niente di tutto questo.
5 · Consegna
Escono solo le pagine approvate, e portano con sé la loro storia
Una pagina approvata viene esportata come testo semplice, come PAGE XML con le coordinate di ogni blocco, e con un registro di provenienza in W3C PROV che indica la scansione di origine, il modello e la sua versione, la persona che l'ha approvata e i diritti. Le pagine che nessuno ha approvato non vengono esportate. Le istituzioni culturali mantengono la piena sovranità sui loro dati, sui loro archivi e sui modelli addestrati.
Dietro l'editor c'è lo strato umano del progetto: uno schema di metadati, una tassonomia e un codebook, e la revisione esperta di significato, contesto, bias e omissioni, progettati da CREAaps.