Risultati
Questi sono i numeri del 5 e 6 novembre 2026, i primi due giorni di prove di lettura su Leonardo, con le seconde letture dell'11 novembre e gli addestramenti del 14 e 15 novembre. I campioni sono piccoli, e diciamo quali. Ogni tasso di errore è misurato rispetto a una trascrizione fatta da persone.
Come misuriamo
Otto pagine di prova difficili di proposito: minuscola e corsiva greca dal X al XVI secolo, greco politonico a stampa, latino in gotica e in corsiva documentaria, naskh arabo e scrittura maghrebina. Ognuna viene da un dataset pubblico con una trascrizione fatta da persone. Nessuna delle otto pagine viene mai usata per addestrare i nostri modelli.
La cifra è il tasso di errore sui caratteri: la quota di caratteri che bisognerebbe cambiare per trasformare la lettura della macchina in quella umana, dopo la normalizzazione Unicode. 0 % è una lettura perfetta.
Un'avvertenza. Il modello di base pubblico da cui partiamo per l'affinamento aveva alcune di queste pagine nei propri dati di addestramento. In quei casi la cifra è segnata con un asterisco e va letta come il caso più favorevole, non come una misura. I modelli che addestriamo da zero non le hanno mai viste, quindi le loro cifre sono pulite.
Dentro una collezione
È la situazione per cui il progetto è pensato: un curatore corregge alcune pagine di un manoscritto o di un fondo, un modello impara da quelle e legge il resto. Qui tutto il manoscritto, tranne la pagina di prova, era disponibile per l'addestramento.
| Pagina di prova | Miglior modello generalista | Addestrato qui, da zero | Addestrato qui, affinato |
|---|---|---|---|
| EPARCHOS, corsiva greca, 1500 circa | 46,9 % | 7,6 % | 4,3 %* |
| Patrologia Graeca vol. 145, greco politonico a stampa | 4,9 % | 1,2 % | 0,8 % |
| Stavronikita 114, minuscola greca, XV secolo | 50,5 % | 19,8 % | 7,4 %* |
| Palatinus graecus 23, minuscola greca, X secolo | 59,8 % | 26,7 % | 14,2 %* |
| Sinai Arabic 418, naskh arabo cristiano, XIII secolo | 18,2 % | 17,5 % | 16,0 %* |
| BULAC MS.ARA.609, scrittura maghrebina, 1734 | 34,8 % | 20,5 % | 17,8 %* |
| e-NDP, corsiva documentaria latina, Notre-Dame di Parigi | 50,5 % | 21,1 % | 17,1 % |
| Rps 12533, gotica libraria latina | 37,3 % | 36,0 % | 25,2 % |
Miglior modello generalista: il valore più basso fra olmOCR-2 (7B) e LightOnOCR-3-1B in tutte le configurazioni che abbiamo provato, leggendo la pagina intera o le righe tracciate da persone. Se quei modelli abbiano visto queste pagine durante il loro addestramento non è documentato. Addestrato qui: riconoscitori di righe Kraken, architettura PP-OCRv6, una GPU A100 ciascuno, fra una e tre ore. * Il modello di base della colonna «affinato» aveva questa pagina nei suoi dati di addestramento.
Il greco è dove il guadagno è più netto: un manoscritto del 1500 circa scende dal 47 % a meno dell'8 % di caratteri sbagliati, con un modello che non ha mai visto la pagina. Sul greco a stampa l'errore è di circa un carattere su cento. Sul naskh arabo siamo alla pari con il miglior modello generalista; sulla scrittura maghrebina siamo nettamente avanti. La mano gotica latina si muove appena, perché c'erano solo quattordici pagine di quel tipo da cui imparare.
L'11 novembre abbiamo letto le stesse otto pagine con un terzo modello generalista, Mistral-Small-3.2 (24 miliardi di parametri), per verificare se un modello di visione e linguaggio più grande fa meglio. Non fa meglio. Il suo errore va dal 61 % sulla corsiva greca a oltre il 400 % sul greco a stampa e sulla gotica latina, perché scrive testo che sulla pagina non c'è. La colonna del miglior modello generalista non cambia.
Il 14 e 15 novembre abbiamo provato anche due OCR piccoli usciti questo autunno, MiniCPM-OCR-1.0 e Xiaomi-OCR-0. Leggono una pagina in pochi secondi, ma nessuno dei due batte il miglior modello generalista su nessuna delle otto pagine: sul greco a stampa sbagliano il 16 % e il 21 % dei caratteri, contro il 4,9 %.
Una mano che il modello non ha mai visto
Qui l'intero manoscritto della pagina di prova è stato tenuto fuori dall'addestramento. È la domanda più difficile: un modello impara una scrittura, o solo le mani che gli sono state mostrate?
| Pagina di prova | Addestrato qui, da zero | Miglior modello pubblico specializzato |
|---|---|---|
| Patrologia Graeca vol. 145, stampa | 2,0 % | 1,5 % |
| Stavronikita 114, minuscola | 31,5 % | 24,5 % |
| EPARCHOS, corsiva | 53,0 % | 37,6 % |
| Palatinus graecus 23, minuscola | 73,3 % | 31,1 % |
| Sinai Arabic 418, naskh | 38,9 % | 36,5 % |
| BULAC MS.ARA.609, maghrebina | 25,9 % | 22,5 % |
Modelli pubblici: CLLG (greco a stampa; potrebbe aver visto la Patrologia), greekmix di Annette von Stockhausen (minuscola greca), TariMa di BULAC e Calfa (arabo), come pubblicati su Zenodo.
Su una mano che non ha mai visto, un piccolo modello addestrato su un numero di righe fra nove e diciottomila non è migliore dei migliori modelli pubblicati. Non ce lo aspettavamo. È il limite onesto del lavoro di oggi, e il motivo per cui il progetto addestra su ogni collezione con pagine corrette dai curatori della collezione stessa.
Quante pagine corrette servono
Un curatore vuole sapere quante pagine deve correggere prima che la macchina lo aiuti. Il 14 novembre, su Leonardo, abbiamo affinato modelli che non avevano mai visto quattro delle collezioni di prova, con 5, 10, 25, 50 e tutte le loro pagine, e abbiamo riletto ogni pagina di prova.
| Collezione | 0 pagine | 5 | 10 | 25 | 50 | Tutte |
|---|---|---|---|---|---|---|
| EPARCHOS, corsiva greca | 53,0 % | 23,8 % | 18,5 % | 11,4 % | 7,8 % | 7,1 % (114) |
| Stavronikita 114, minuscola greca | 31,5 % | 28,1 % | 19,9 % | 18,3 % | – | 15,5 % (38) |
| e-NDP, corsiva documentaria latina | 32,1 % | 28,6 % | 28,0 % | 24,6 % | 21,3 % | 18,5 % (505) |
| Sinai arabo 418, naskh | 38,9 % | 26,6 % | 25,9 % | 28,5 % | 20,9 % | 19,9 % (336) |
Una pagina di prova per collezione, mai usata nell'addestramento. Stavronikita ha 43 pagine, quindi manca il punto a 50. Il numero di epoche era fisso, non tarato.
Sulla corsiva greca cinque pagine corrette dimezzano l'errore, e cinquanta arrivano quasi dove arriva la collezione intera. Sulle altre tre il guadagno è più lento, e il grosso arriva solo con tutta la collezione. Una pagina per collezione dà una curva, non una promessa: un punto può spostarsi di qualche punto percentuale, come fa l'arabo fra 10 e 25 pagine.
La scrittura a mano in inglese e in italiano, da dati aperti
Due delle nostre collezioni pilota sono lettere in inglese e carte italiane del Novecento, e nessuna loro pagina è ancora corretta. Così abbiamo addestrato su trascrizioni a licenza aperta e misurato su pagine che i modelli non avevano mai visto.
| Insieme di prova | Modello generalista (PP-OCRv6) | Addestrato qui |
|---|---|---|
| Carte di Bentham, insieme di prova ufficiale della gara ICDAR 2015, 50 pagine | 17,5 % | 12,8 % |
| Revolutionary City, lettere della Library of Congress, 146 pagine di mani mai viste nell'addestramento | 13,5 % | 11,9 % |
| Modello | Errore |
|---|---|
| Modello generalista (PP-OCRv6) | 8,7 % |
| Addestrato su 72.723 righe di scrittura a mano moderna, quasi tutte francesi | 13,7 % |
| Modello generalista, poi 45 pagine del diario | 6,1 % |
| Scrittura a mano moderna, poi 45 pagine del diario | 5,1 % |
In inglese il guadagno c'è ma è moderato, perché il modello generalista legge già discretamente le mani inglesi. In italiano la lezione è più netta: un modello addestrato su mani francesi legge l'italiano peggio di quello generalista, e l'errore scende solo quando ha visto pagine della collezione stessa. È proprio così che il progetto è pensato. I numeri italiani poggiano su due pagine, circa duemila caratteri: un punto di differenza è dentro il rumore.
Dati aperti usati, con un grazie: Transcribe Bentham, dataset ICDAR 2015 HTRtS (CC BY 4.0); The Revolutionary City Corpus 1758-1805 (CC BY 4.0); CATMuS Modern (CC BY 4.0); il diario di Bruno Celestino da Europeana 1914-1918, trascrizioni CC0 e immagini CC BY-SA 3.0.
Spartiti
Quattro pagine con una trascrizione simbolica fatta da persone (OpenScore, pubblico dominio), lette da copisteria in MusicXML e confrontate simbolo per simbolo con musicdiff (OMR-NED).
| Pagina | Errore |
|---|---|
| Mozart, Quartetto per archi K.155, edizione Breitkopf del 1881, pagina 1 | 4,5 % |
| Mozart, Quartetto per archi K.465, edizione Breitkopf del 1882, pagina 1 | 6,5 % |
| Beethoven, Quartetto per archi op. 18 n. 1, edizione Breitkopf, pagina 1 | 7,8 % |
| Mozart, Quartetto per archi K.155, manoscritto autografo, pagina 1 | 96,9 % |
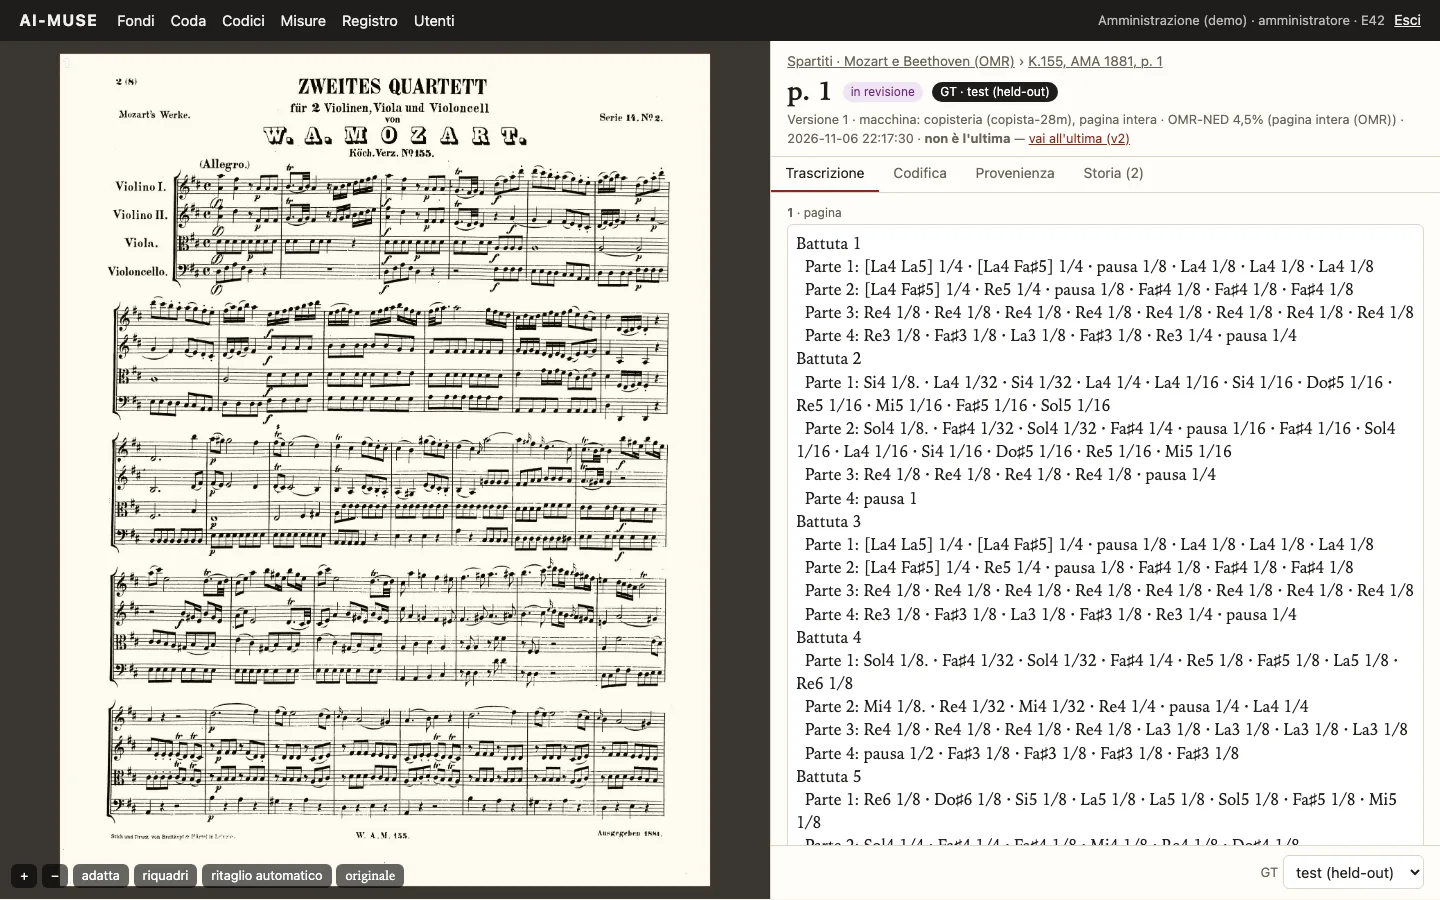
La musica a stampa viene letta bene: battute e parti escono giuste, e gli errori sono singole note e segni. La mano di Mozart non viene letta affatto: il modello vede otto parti di cinque battute invece di quattro parti di quattordici. Le cifre sulla stampa potrebbero essere migliori del vero, perché il modello è stato addestrato su una grande raccolta di partiture che potrebbe comprendere questi brani.
L'11 novembre abbiamo letto su Leonardo tutte le 53 pagine dei tre quartetti e dei due autografi, in dodici minuti su una GPU. Solo le prime pagine hanno una trascrizione divisa per pagina, quindi solo quelle sono misurate: le cifre sono risultate entro 0,2 punti da quelle qui sopra.
Il giornale
Su «Giustizia e Libertà» non c'è ancora una trascrizione umana, quindi non c'è un tasso di errore. Quello che possiamo riportare è il comportamento. Su quattordici pagine, circa 1.300 blocchi, olmOCR-2 si è fermato prima del tempo una volta. LightOnOCR-3-1B, il miglior modello generalista sui manoscritti qui sopra, si è ripetuto senza fine o si è fermato prima del tempo 355 volte, e su diversi blocchi ha descritto immagini invece di leggere il testo. Le due letture sono nell'editor, e le correzioni di un curatore su poche pagine daranno la prima cifra misurata.
L'11 novembre tutte le 70 pagine del campione di giornale sono state lette una seconda volta, da Mistral-Small-3.2. Senza una trascrizione umana questo non dice chi ha ragione, ma dice dove guardare. Le due letture hanno in comune l'89 % delle parole sulla pagina mediana; le pagine dove differiscono di più sono quelle che un curatore dovrebbe aprire per prime. Mistral si è ripetuto senza fine o si è fermato prima del tempo su 14 blocchi, olmOCR-2 su 5.
Calcolo: circa 24 ore GPU il 6 novembre 2026 per dieci addestramenti, due calibrazioni e le letture del giornale; circa 3 ore GPU l'11 novembre per le seconde letture e gli spartiti; circa 22 ore GPU il 14 e 15 novembre per la curva delle pagine e i modelli inglese e italiano.
We acknowledge EuroHPC JU for awarding the project ID EHPC-AIF-2026PG01-1068 access to 5,000 GPU hours on Leonardo Booster hosted by CINECA, Italy.