Per la prima volta nella storia: un supercomputer italiano legge l'illeggibile manoscritto Voynich con il 92% di precisione
· AI-MUSE
Trascritto, non decifrato: nessuno, noi compresi, sa cosa dice.
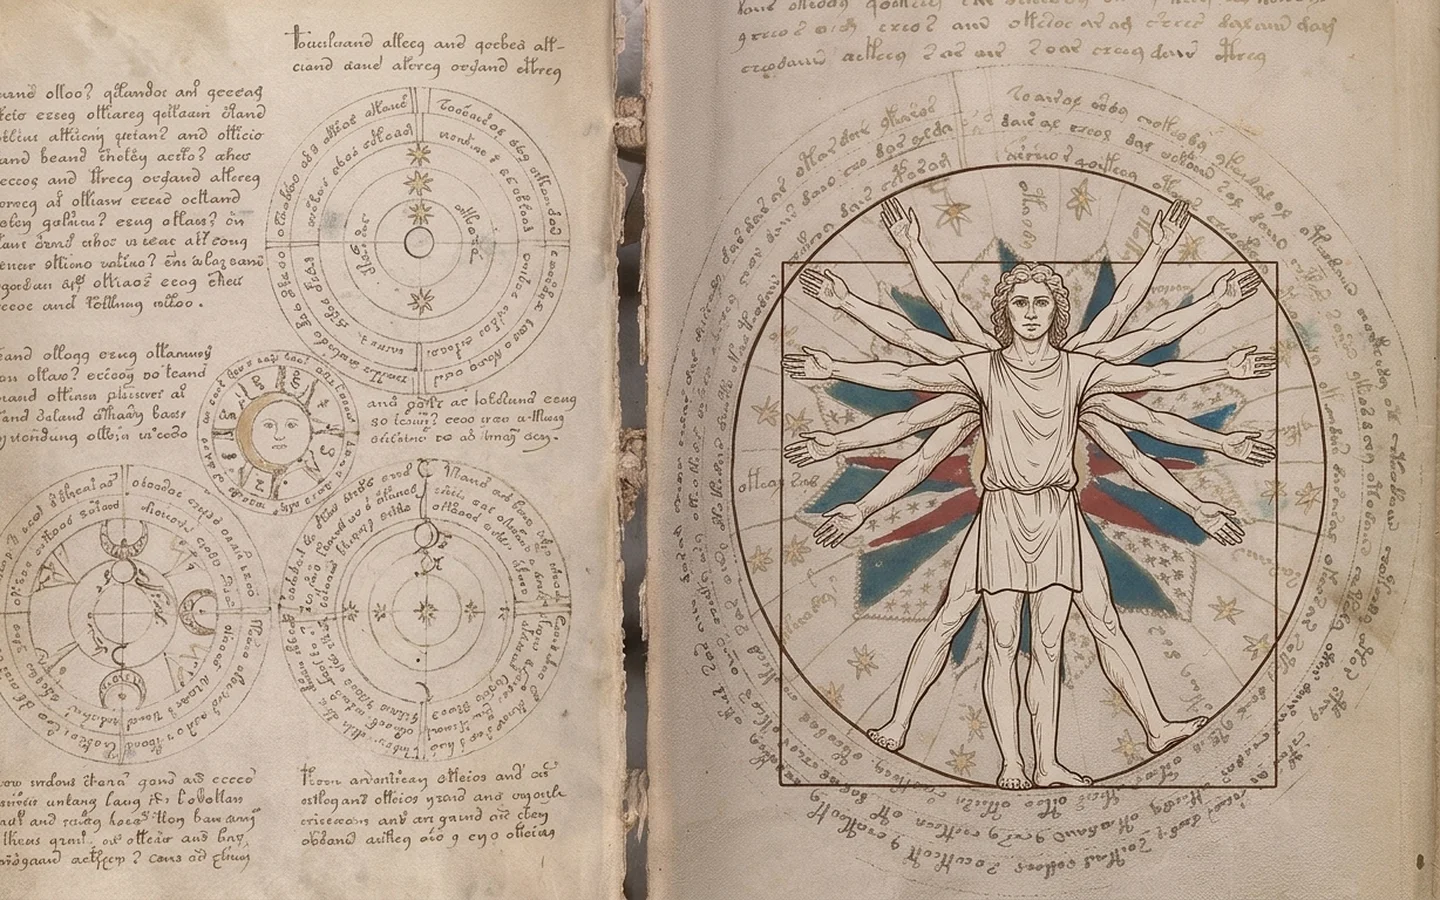
Nessuno sa cosa dice il manoscritto Voynich. La sua scrittura sconosciuta resiste a crittografi e linguisti da più di un secolo, e ogni soluzione annunciata è crollata alla prova dei fatti. Quando abbiamo avviato la nostra catena sperimentale di elaborazione dei documenti sul supercomputer Leonardo del CINECA, l'11 ottobre 2026, non abbiamo cercato di decifrarlo. Ci siamo dati un obiettivo misurabile e riproducibile: addestrare un sistema di IA a leggere e trascrivere i suoi segni, riga per riga, alla scala di un supercomputer.
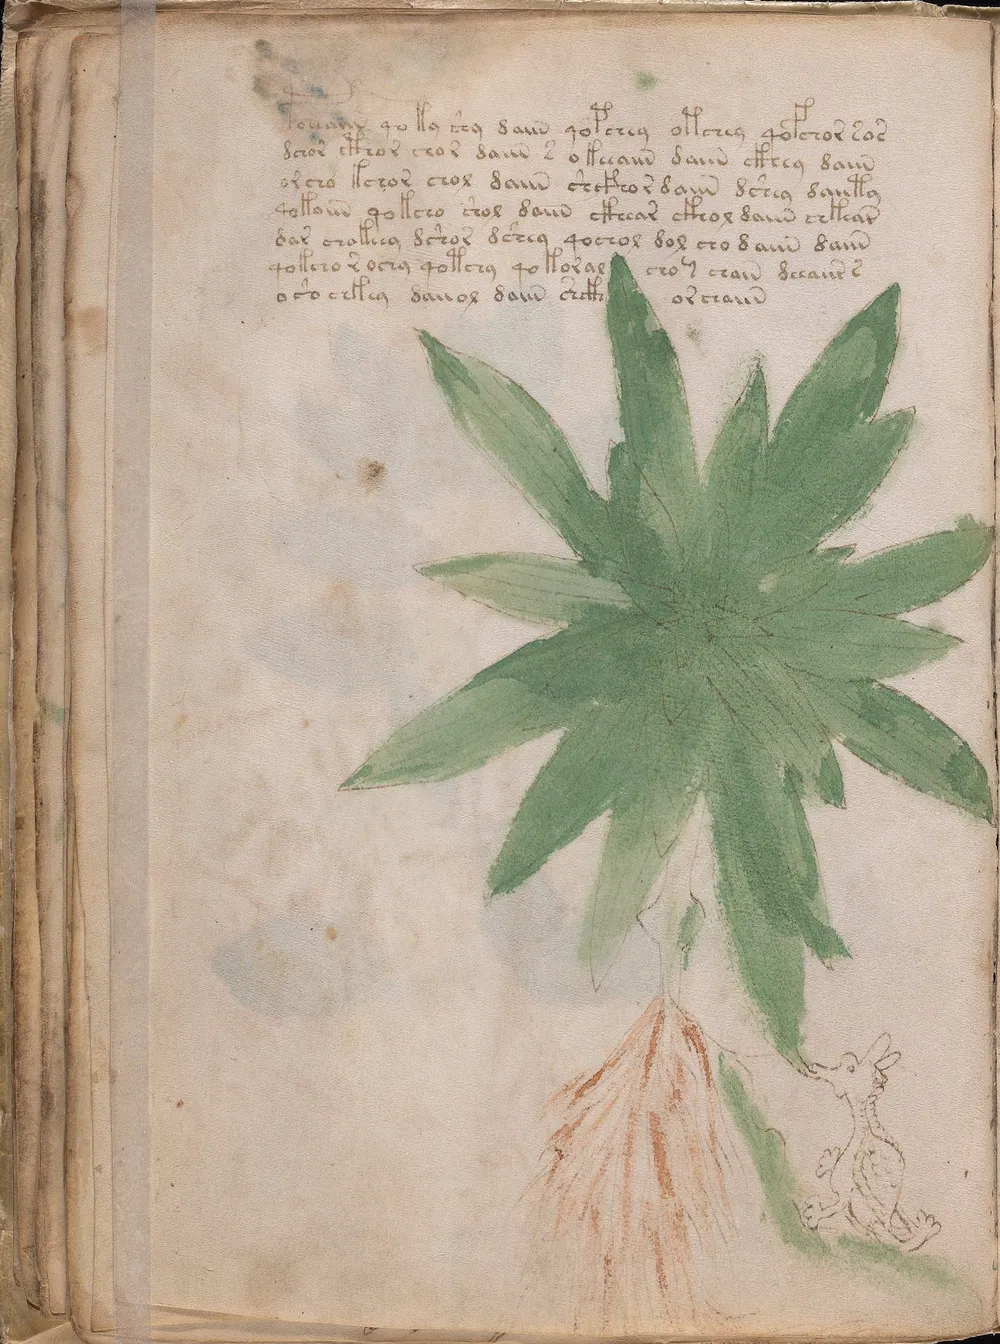
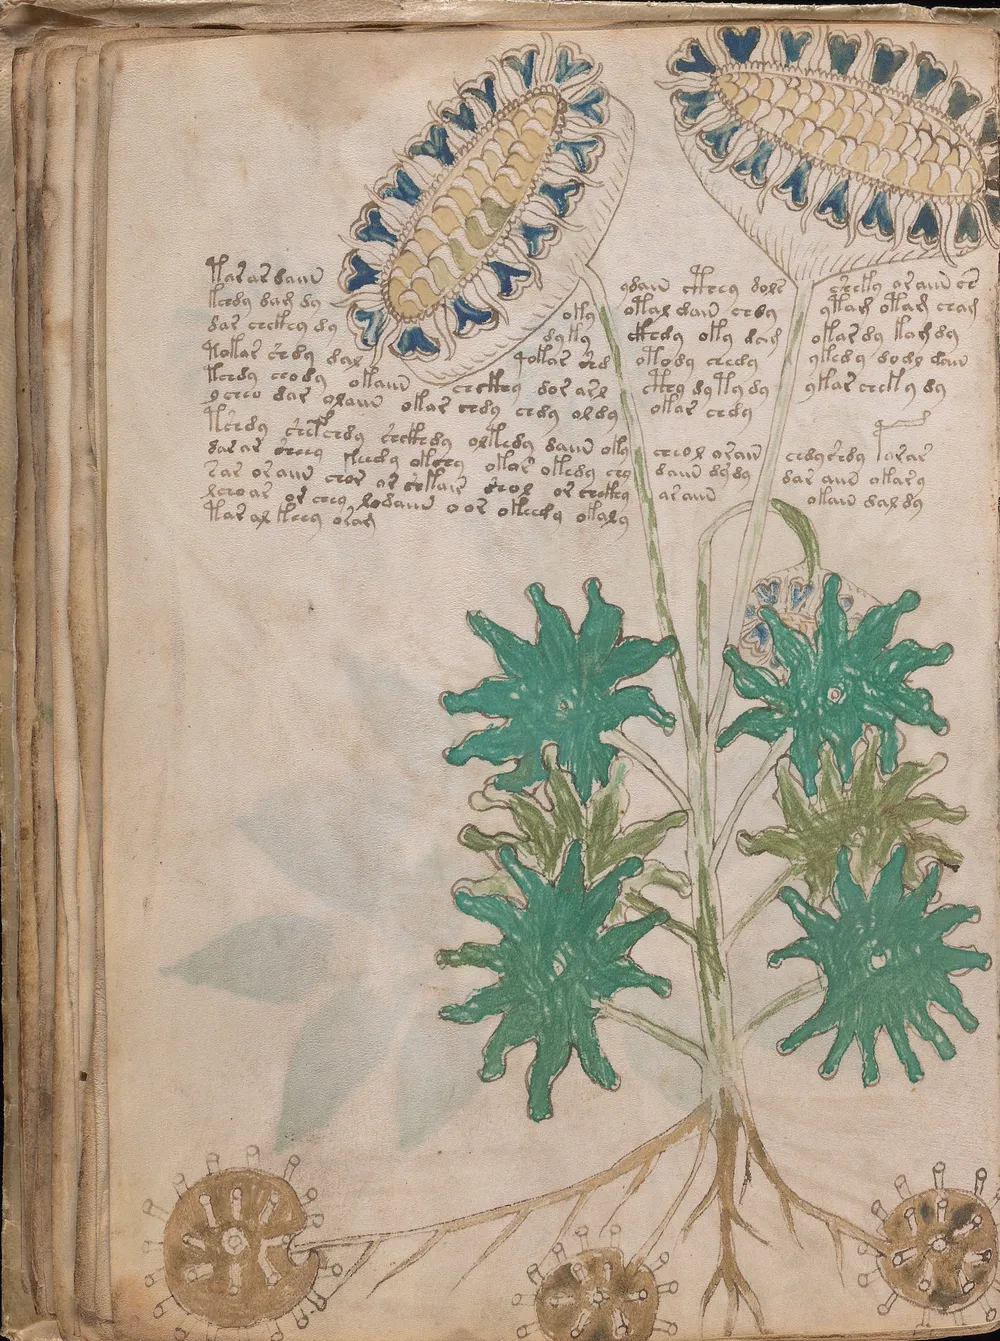
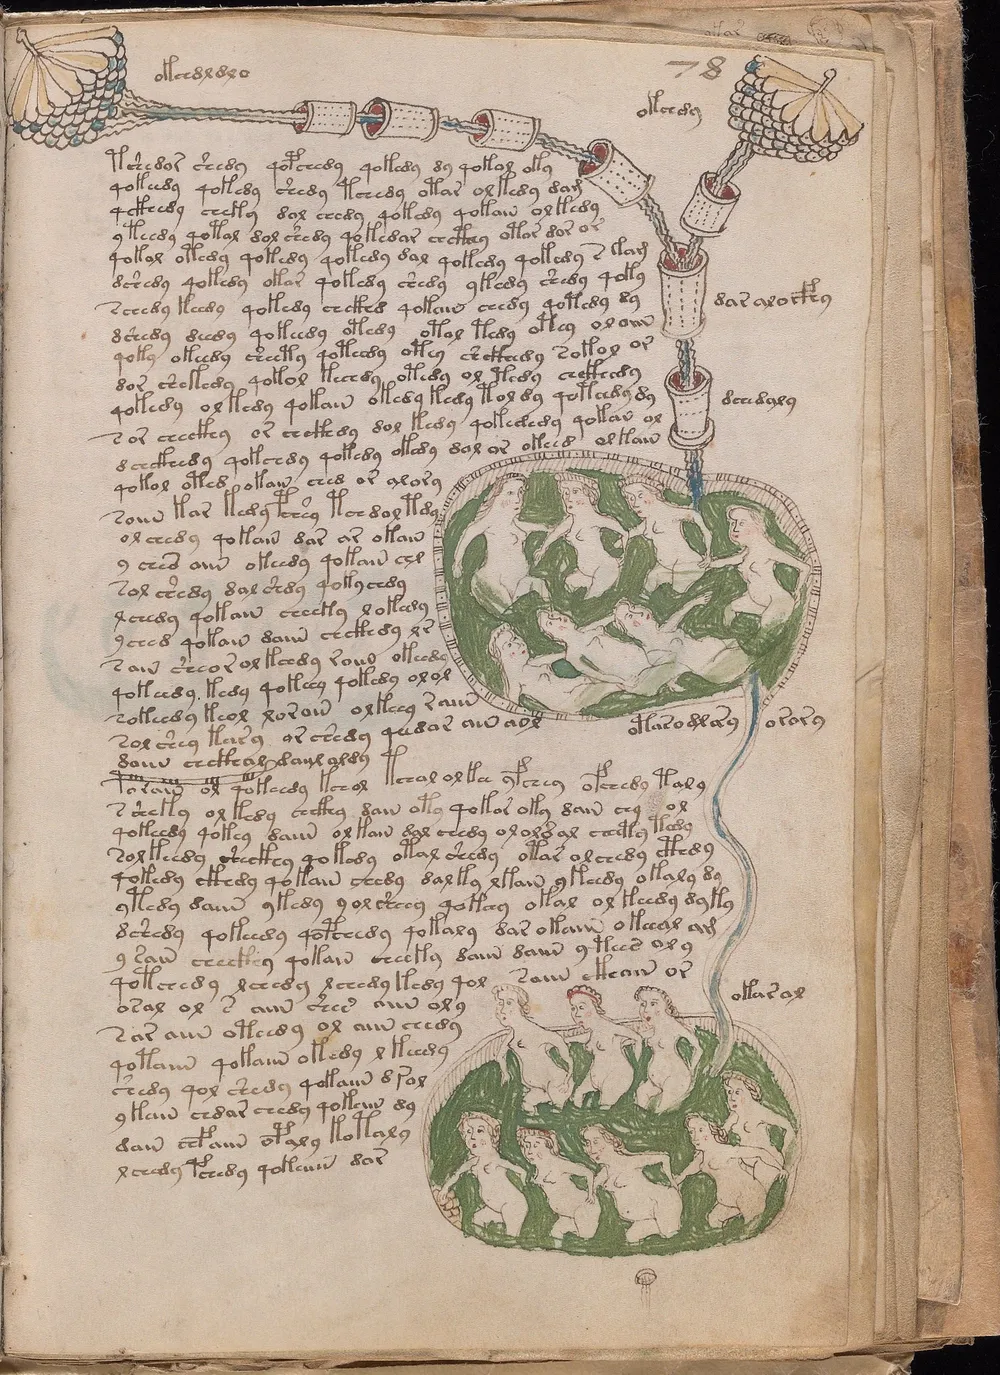
Piante che non crescono da nessuna parte, una piccola creatura alla radice, figure che fanno il bagno in vasche verdi unite da tubi: fogli 25v, 33v e 78r. Beinecke Rare Book and Manuscript Library, Yale University, MS 408.
La sfida estrema per un archivio
Una scrittura non decifrata è il caso estremo del problema d'archivio di cui si occupa AI-MUSE. I modelli di lettura generalisti si appoggiano alle lingue moderne e a un vocabolario prevedibile; davanti a una scrittura sconosciuta non hanno nulla a cui aggrapparsi e inventano a ruota libera. Quello che serve a un modello neurale è un'àncora: trascrizioni fatte da studiosi, da cui un modello di riconoscimento impara la morfologia di ciascuna mano. Per il Voynich gli studiosi hanno costruito questa base in decenni di lavoro. La domanda era se la nostra architettura, in funzione su un'infrastruttura europea di supercalcolo, potesse leggere il resto del manoscritto, pagina per pagina, e con quanta precisione.
La catena di elaborazione sul supercomputer
Siamo partiti da due risorse aperte: le scansioni ad alta risoluzione del Beinecke MS 408 pubblicate in accesso aperto dalla Yale University, e la trascrizione ZL di riferimento di René Zandbergen nell'alfabeto EVA (formato IVTFF, CC0). Abbiamo usato le 177 pagine singole, lasciando per dopo i fogli ripiegati, e ci siamo concentrati sulle righe di testo in paragrafo.
La nostra catena ha segmentato le righe di ogni pagina e le ha allineate alla trascrizione umana. Dove l'allineamento era ambiguo, per 29 pagine, abbiamo isolato quei fogli per valutarli a parte. Poi abbiamo addestrato da zero dieci modelli di riconoscimento indipendenti sul cluster di GPU NVIDIA A100 di Leonardo. Ogni modello si è addestrato su nove decimi delle pagine e ha letto il decimo che non aveva mai visto. Ogni pagina è stata trascritta alla cieca da un modello che quel foglio non l'aveva mai visto prima, in circa 35 minuti per modello su Leonardo.
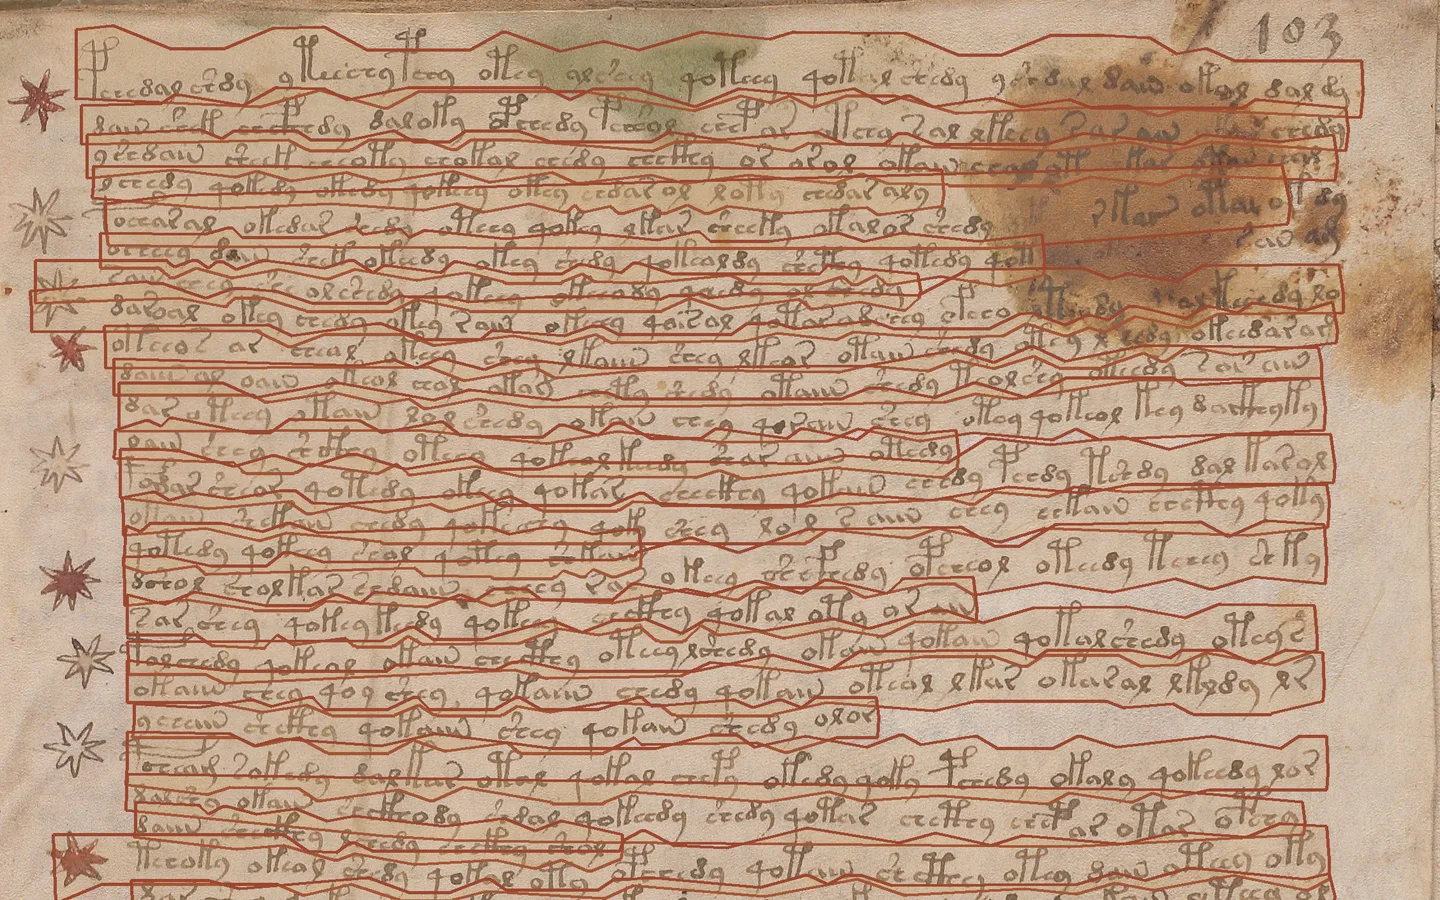
I numeri: 91,8% di caratteri corretti
- 8,2%di tasso di errore sui caratteri complessivo, su 2.651 righe in 125 pagine mai viste prima (7,9% senza contare gli spazi).
- 6,1%sulla mano che gli studiosi chiamano «Mano 3», soprattutto nella sezione delle ricette.
- 12,2%sulla «Mano 1» nella sezione erbaria, dove i grandi disegni di piante rompono la geometria delle righe.
La Mano 2 si è fermata al 7,3%, mentre la Mano 5, con solo qualche decina di righe da cui imparare, è arrivata al 16,0%. Metà delle pagine di prova ha un tasso di errore sotto l'8,3%, e venti pagine sono sotto il 5%. Se si considera che le trascrizioni umane del Voynich in EVA differiscono fra studiosi dal 3% al 5% (secondo Zandbergen), i nostri modelli addestrati sul supercomputer lavorano proprio al limite teorico del consenso.
Trascrizione e decifrazione
Niente di tutto questo sostiene che il manoscritto sia stato decifrato. Una trascrizione trasforma segni visivi in caratteri di un alfabeto elaborabili al computer; non li trasforma nelle parole di una lingua nota. L'apprendimento automatico porta la velocità, la ripetibilità e la precisione delle coordinate che l'occhio umano non può reggere su centinaia di pagine. Se il Voynich verrà mai decifrato, a farlo saranno delle persone, e trascrizioni verificate e abbinate riga per riga come questa sono lo strumento di calcolo che serve loro per riuscirci.
Cosa viene dopo
Un secondo passaggio sui fogli in cui impaginazioni complesse hanno disturbato l'allineamento delle righe, una verifica umana su un campione di allineamenti, le etichette e il testo astronomico circolare. E infine la pubblicazione, con licenza aperta, per i ricercatori di tutto il mondo, delle coordinate digitali complete di ogni riga abbinata alla trascrizione.
Scansioni: Beinecke Rare Book and Manuscript Library, Yale University, MS 408. Trascrizione: ZL 3b, René Zandbergen, CC0. Modelli di riconoscimento: Kraken 7.1.1. AI-MUSE ha ottenuto risorse di calcolo attraverso IT4LIA AI Factory (EuroHPC), progetto EHPC-AIF-2026PG01-1068. L'elaborazione gira su Leonardo Booster, al CINECA di Bologna. Ringraziamento richiesto da EuroHPC: We acknowledge EuroHPC JU for awarding the project ID EHPC-AIF-2026PG01-1068 access to 5,000 GPU hours on Leonardo Booster hosted by CINECA, Italy.