Due giorni su Leonardo: sei volte meno errori
· AI-MUSE
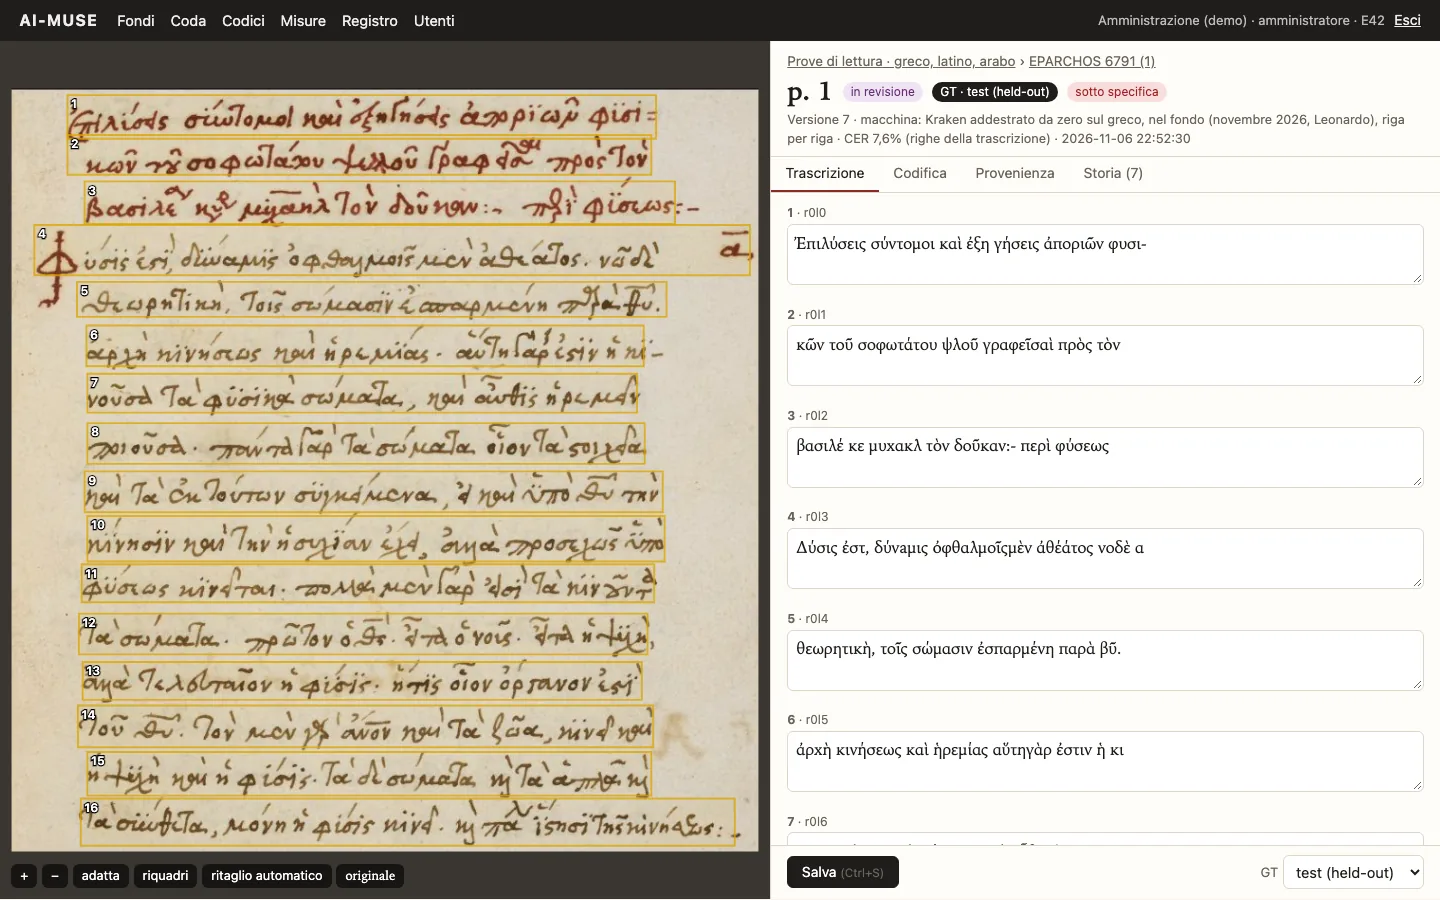
Su una mano greca del 1500 circa, il miglior modello di lettura generalista sbaglia quasi un carattere su due. Il nostro, addestrato sul resto dello stesso manoscritto in poche ore su una GPU, ne sbaglia meno di uno su tredici: sei volte meno errori. Il 5 e il 6 novembre 2026 abbiamo addestrato dieci modelli come questo su Leonardo, il supercomputer del CINECA a Bologna, abbiamo letto un giornale del 1945 e provato quattro pagine di quartetti d'archi. Questo è tutto quello che ne è uscito, compreso ciò che non ha funzionato.
La domanda
I modelli di lettura generalisti imparano soprattutto dalla stampa moderna. Su sei delle nostre otto pagine di prova, il migliore sbaglia più di un terzo dei caratteri. L'idea di AI-MUSE è che un curatore corregga alcune pagine di una raccolta, che un piccolo modello impari quella mano da quelle pagine e che legga il resto. Volevamo sapere fin dove si arriva, misurando su pagine che i modelli non avevano mai visto.
Dieci modelli in un giorno
Abbiamo addestrato con Kraken modelli di riconoscimento delle righe su righe tagliate da dataset pubblici con trascrizioni fatte da persone, tutti con licenze che lo permettono: minuscola e corsiva greca, greco politonico a stampa, latino, arabo cristiano e scrittura maghrebina. Ogni addestramento ha usato una GPU A100 per una-tre ore; nel solo 6 novembre circa 24 ore GPU sono andate in dieci addestramenti, due calibrazioni e il giornale. Otto pagine di prova sono rimaste fuori dall'addestramento per tutto il tempo.
- 7,6%di caratteri sbagliati sulla corsiva greca del 1500 circa. Il miglior modello generalista: 46,9%.
- 1,2%sul greco politonico a stampa, Patrologia Graeca. Prima: 4,9%.
- 20,5%sulla scrittura araba maghrebina del 1734. Prima: 34,8%.
Questi modelli sono stati addestrati da zero e non hanno mai visto la pagina di prova, quindi i valori sono puliti. Affinare (fine-tuning) un modello di base pubblico porta ancora più in basso, 4,3% sulla stessa pagina greca, ma quel modello di base aveva alcune delle nostre pagine di prova fra i suoi dati di addestramento, quindi riportiamo i suoi valori come un tetto, non come una misura. Sul latino l'affinamento porta una corsiva documentaria di Notre-Dame di Parigi dal 50,5% al 17,1%, e un modello addestrato da zero, che ha finito la notte successiva, arriva al 21,1%.
Dove non siamo migliori
Ci siamo posti anche la domanda più difficile: cosa succede su una mano che il modello non ha mai visto, tenendo fuori dall'addestramento l'intero manoscritto? Lì i nostri piccoli modelli non sono migliori dei migliori pubblicati: 31,5% contro 24,5% su una minuscola greca del XV secolo, 25,9% contro 22,5% sulla scrittura maghrebina. Con nove-diciottomila righe per scrittura, un modello impara le mani che gli si mostrano, non la scrittura in generale. Sul naskh arabo cristiano siamo alla pari con il miglior modello generalista anche dentro la raccolta: 17,5% contro 18,2%.
Per questo il progetto addestra su ogni raccolta, con pagine corrette dai suoi curatori.
Un giornale del 1945, letto due volte
Abbiamo letto quattordici pagine di «Giustizia e Libertà», il settimanale veneziano del Partito d'Azione, circa 1.300 blocchi, con due modelli generalisti. Scansioni per gentile concessione dell'IVESER. olmOCR-2 si è interrotto prima della fine una volta. LightOnOCR-3-1B, il miglior modello generalista sui manoscritti visti sopra, si è messo a ripetersi o si è interrotto prima della fine 355 volte, e su alcuni blocchi ha descritto immagini che sulla pagina non ci sono: un motivo astratto, una sigaretta con un'etichetta nera.
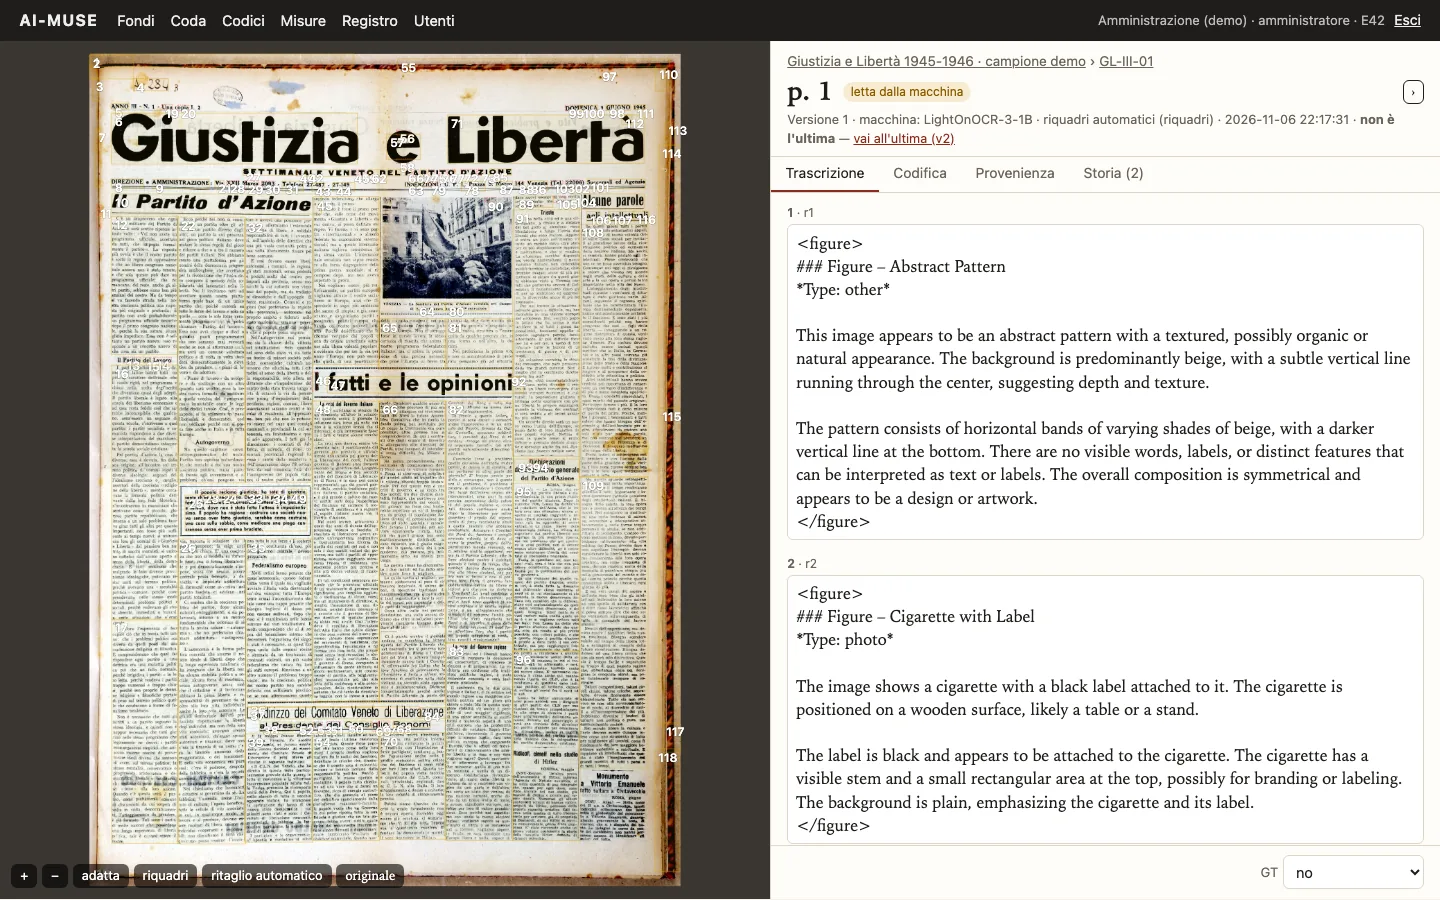
L'editor segnala da solo le ripetizioni e i blocchi troncati. L'invenzione non la può cogliere: si legge come un inglese plausibile, e solo una persona che guarda la pagina vede che lì non c'è niente di tutto questo. Le due letture sono nell'editor perché i curatori dell'IVESER le confrontino e le correggano, e le loro correzioni daranno il primo tasso di errore misurato su questo giornale.
Mozart
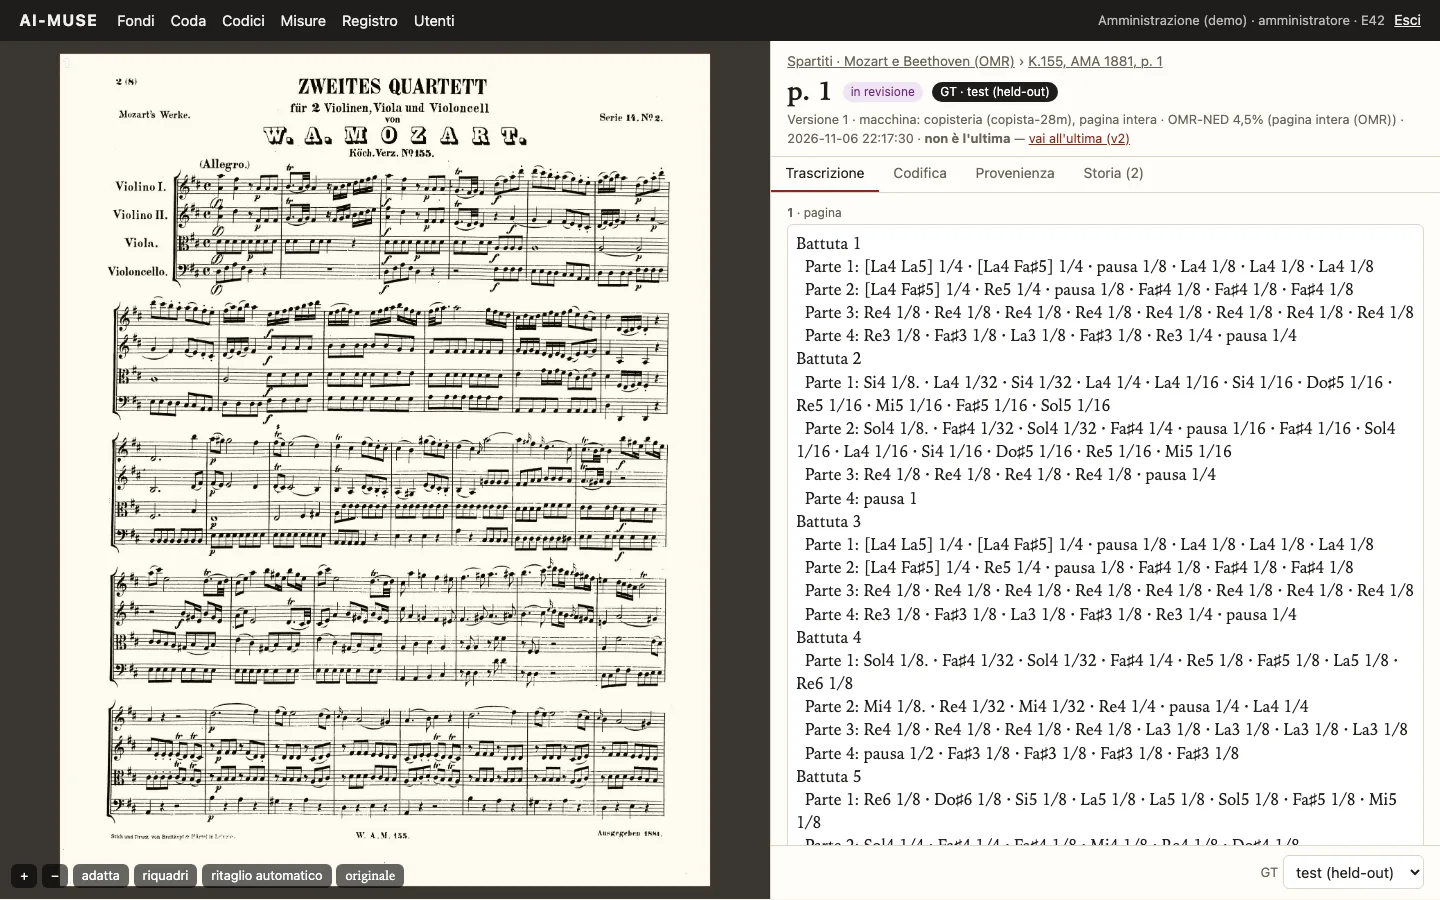
Per un archivio anche la musica è testo. copisteria, un modello open source, ha letto quattro pagine di quartetti d'archi in MusicXML, e le abbiamo confrontate simbolo per simbolo con trascrizioni fatte da persone: 4,5% di simboli sbagliati sul K.155 di Mozart nell'edizione del 1881, 6,5% sul K.465, 7,8% sull'op. 18 n. 1 di Beethoven.
Sulla prima pagina del manoscritto autografo di Mozart del K.155 fallisce del tutto, 96,9%: vede otto parti di cinque battute invece di quattro parti di quattordici. Leggere la mano di un compositore è la prossima cosa su cui addestrare.
Cosa significa
Dentro una raccolta, un modello addestrato sulle sue pagine batte di molto quelli generalisti sul greco e sulla scrittura maghrebina. Su una mano che non ha mai visto no, non ancora. E una lettura scorrevole può essere pura invenzione. Ogni valore citato qui è nella pagina Risultati con le sue fonti, e ogni lettura è nell'applicazione, in attesa che una persona dica sì.
AI-MUSE ha ottenuto risorse di calcolo attraverso IT4LIA AI Factory (EuroHPC), progetto EHPC-AIF-2026PG01-1068. L'elaborazione gira su Leonardo Booster, al CINECA di Bologna. Ringraziamento richiesto da EuroHPC: We acknowledge EuroHPC JU for awarding the project ID EHPC-AIF-2026PG01-1068 access to 5,000 GPU hours on Leonardo Booster hosted by CINECA, Italy.